Assessing GPT-4 for cell type annotation in single-cell RNA-seq analysis
https://www.nature.com/articles/s41592-024-02235-4
2024, nautre methods, 342 citation
GPT-4의 자동 세포 유형 분류를 위한 R 소프트웨어 패키지인 GPTCelltype
1. Problem
- 세포 유형 주석은 노동 집약적이고 시간이 많이 소요되는 작업이다.
- CellMarker2.0(, SingleR , ScType와 같은 자동화된 세포 유형 주석 방법이 개발되었지만,
여전히 마커 유전자를 이용한 수동 주석 방식이 널리 사용되고 있다. - GPTCelltype 은 GPT-4의 방대한 학습 데이터는 다양한 조직 및 세포 유형에 걸쳐 더 폭넓은 응용을 가능하게 하며, 챗봇 특성 덕분에 사용자가 직접 주석을 개선할 수 있다.

scRNA-seq 세포 유형 주석 3가지 방식 비교
1. Human Expert Manual Annotation (전문가 수동 주석)
장점: 생물학 전문 지식을 바탕으로 높은 정확도의 주석이 가능하며, 코딩 능력이 필요 없고 참조 scRNA-seq 데이터 없이도 수행할 수 있다. 조직 유형에 제한이 없고, 기존 분석 파이프라인에 자연스럽게 통합되며, 세포 유형의 세분화 수준(granularity)을 자유롭게 조정할 수 있다.
단점: 강한 생물학 전문 지식이 반드시 요구되므로 진입 장벽이 높고, 상당한 시간과 노력이 소요된다.
2. GPT-4 Automated Annotation (GPT-4 자동 주석)
장점: 생물학 전문 지식이나 코딩 능력 없이도 사용할 수 있어 접근성이 높고, 참조 scRNA-seq 데이터가 필요하지 않다. 최소한의 노력으로 빠르게 결과를 얻을 수 있으며, 기존 파이프라인에 통합 가능하고 조직 유형 제한이 없다. 세분화 수준 조정도 가능하며, 필요시 전문가의 fine-tuning을 선택적으로 추가할 수 있다.
단점: LLM 특성상 hallucination 가능성이 있어 전문가 검수가 필요할 수 있으며, 패널 (b)와 (c)에서 보듯 프롬프트 설계에 따라 결과의 구체성과 정확도가 달라질 수 있다.
3. Other Automated Cell Type Annotation Software (기타 자동 주석 소프트웨어)
장점: 생물학 전문 지식 없이 사용 가능하며, 참조 데이터 기반으로 체계적이고 재현 가능한 주석을 수행할 수 있다.
단점: 중간 수준의 코딩 능력이 필요하고, 참조 scRNA-seq 데이터를 별도로 수집해야 할 수 있다. 독립적인 파이프라인으로 운영되어 기존 워크플로우 통합이 어렵고, 사용 가능한 조직 유형이 참조 데이터에 제한되며, 세분화 수준이 단일 수준으로 고정되어 유연성이 떨어진다.
2. Evaluation & Findings
- 5개 종과 수백 가지 조직 및 세포 유형을 포괄하고
정상 및 암 샘플을 모두 포함하는 10개 데이터 세트에서 성능을 평가했다.
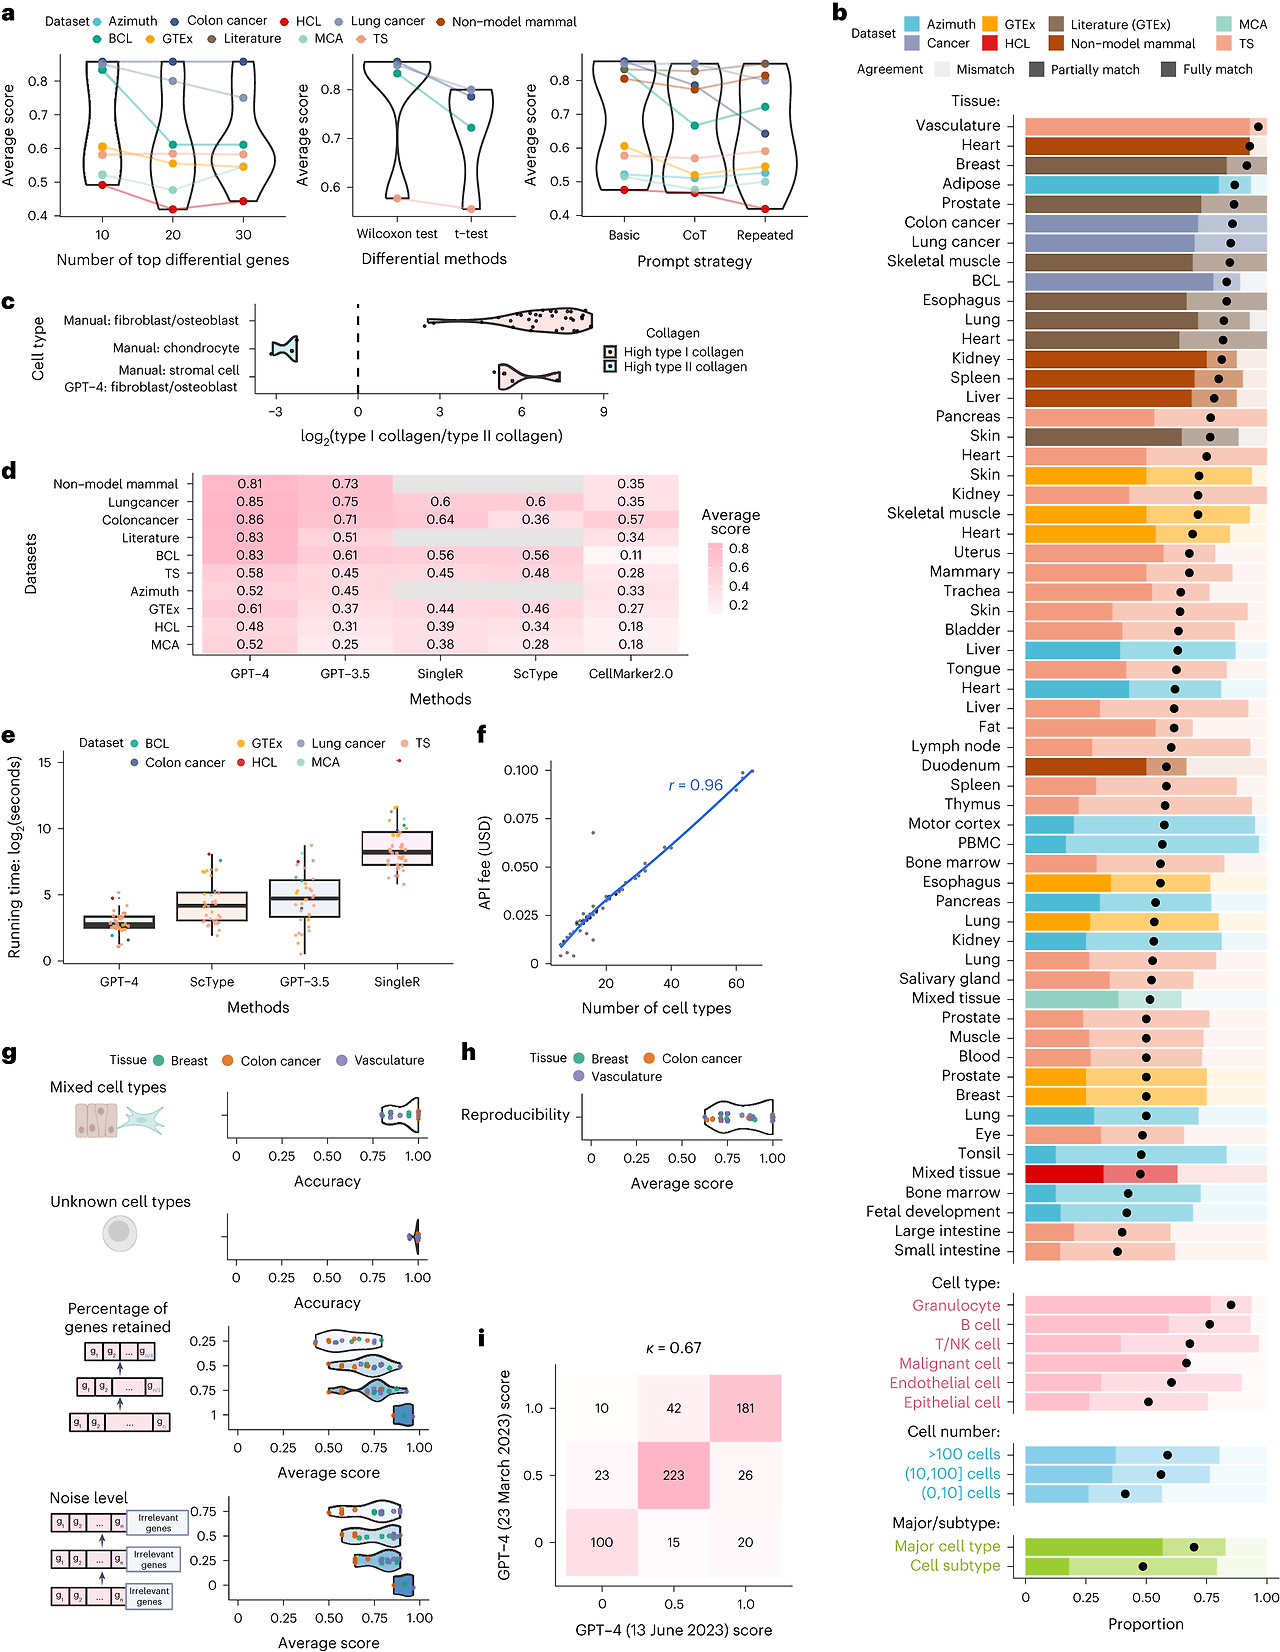
Average score
- 일치도 평가 3단계 분류: 연구진은 원본 논문의 전문가 수동 주석(Manual annotation)과 모델의 자동 주석 결과를 비교하여 다음 3가지 범주로 분류했습니다.
- Fully match (완전 일치): 세포 명칭 또는 Cell Ontology(CL) 이름이 동일한 경우.
- Partially match (부분 일치): 상위 범주(Broad cell type)는 동일하나 하위 주석 명칭이 다른 경우 (예: Fibroblast와 Stromal cell).
- Mismatch (불일치): 상위 범주 및 주석 명칭이 모두 다른 경우.
- 점수 부여 및 평균 산출:
- Fully match = 1점
- Partially match = 0.5점
- Mismatch = 0점
Figure 2a.
- 데이터셋 검증에 앞서, GPT-4에 제공할 유전자 정보의 종류/개수 및 프롬프트 구성 방식에 따른 성능 차이를 확인
- 검증한 3가지 변수
- 상위 차등 발현 유전자 수 (Top differential genes): 상위 10개, 20개, 30개 유전자 입력.
- 차등 분석 통계 기법 (Differential methods): 양측 Wilcoxon rank-sum test vs. t-test.
- 프롬프트 전략 (Prompt strategy):
-
- Basic: 조직 이름과 마커 유전자 목록을 입력하고, 각 줄에 해당하는 세포 타입 이름만 출력하도록 요청
- CoT (Chain-of-Thought): 프롬프트 시작 부분에 *"CD3 유전자는 T 세포 마커이므로, CD3가 포함되어 있으면 T 세포 또는 그 아형일 가능성이 높다"*와 같은 논리적 추론 예시 문장을 추가하여 모델의 단계별 추론을 유도한 방식.
- Repeated: 동일한 Basic 프롬프트로 GPT-4에 5번 연속 Query를 보낸 후, 가장 많이 등장한 답변(다수결)을 최종 결과로 선택한 방식
-
- 결과적으로,
- 상위 10개 유전자, Wilcoxon rank-sum test, Basic을 선택함.
- 이 모델을 기준으로 전체 성능을 figure2 b를 그림.
Figure 2b.
- 전반적인 높은 일치도: 대부분의 연구 및 조직에서 세포 타입의 75% 이상이 Fully match 또는 Partially match를 달성했습니다. (특히 문헌 검색으로 얻은 마커 유전자를 사용했을 때 대부분의 조직에서 Fully match 비율이 70% 이상으로 매우 높았습니다).
- 세포 유형별 특성: 과립구(Granulocytes)와 같은 면역세포에서 특히 뛰어난 성능을 보였습니다. 대장암이나 폐암 데이터셋에서는 암세포(Malignant cells)를 잘 식별했지만, 뚜렷한 유전자 세트가 부족한 B세포 림프종(B lymphoma) 등은 상대적으로 식별에 어려움을 겪었습니다.
- 세포 수의 영향: 세포 수가 10개 이하인 매우 작은 세포 집단(0~10 cells)에서는 제공되는 유전자 정보의 한계로 인해 성능이 소폭 하락했습니다.
- 세분화 수준(Granularity)의 영향: T 세포와 같은 상위 세포 유형(Major cell type)에서 Fully match 비율이 더 높았습니다. CD4 기억 T 세포와 같은 하위 아형(Subtype)으로 갈수록 완전 일치율은 다소 감소하지만, 여전히 하위 아형의 75% 이상에서 Fully 또는 Partially match를 기록하여 높은 정확도를 유지했습니다
Figure 2g.
- 실제 단일 세포 분석 현장에서는 2개 이상의 세포 타입이 섞인 doublet 세포, 알려지지 않은 새로운 세포 타입, 마커 유전자의 일부 누락, 또는 노이즈 유전자 혼입 등 불완전한 데이터 상황이 자주 발생합니다.
- 연구진은 가상의 시뮬레이션 데이터셋을 구축하여, 이러한 복잡하고 열악한 입력 조건에서도 GPT-4가 흔들리지 않고 정확하게 세포 타입을 판별해내는지(강건성)를 검증했습니다.
- 단일 vs 혼합 세포 타입 (Mixed cell types): 순수한 단일 세포 타입과 2개 세포 타입의 마커가 섞인 혼합 세포 타입을 93%의 정확도로 구분했습니다.
- 알려진 vs 미지의 세포 타입 (Unknown cell types): 기존 DB에 있는 알려진 세포 타입과 무작위 유전자로 구성된 미지의 세포 타입을 99%의 정확도로 구별해냈습니다.
- 유전자 정보 누락 (Subsampling / Percentage of genes retained): 입력 마커 유전자 수를 25%, 50%, 75% 수준으로 줄여서 제공해도 점수가 다소 감소할 뿐 여전히 높은 정확도를 유지했습니다.
- 노이즈 유전자 혼입 (Noise level): 무작위 관련 없는 유전자를 노이즈로 섞어 넣어도 정확도가 크게 떨어지지 않고 높은 수준을 유지했습니다.
- 핵심 결론: GPT-4는 마커 유전자가 일부 손실되거나 노이즈가 포함된 불완전한 상황에서도 성능 저하가 적어, 실제 현장의 복잡한 데이터 분석 조건에 매우 뛰어난 강건성을 지님을 확인했습니다.
Figure 2h.
- 대형 언어 모델(LLM)은 생성 시 확률적 요소(Stochastic nature)가 포함되어 있어, 동일한 입력(마커 유전자 목록)을 주더라도 매번 답변이 달라질 위험이 있습니다.
- 연구진은 동일한 마커 유전자 세트를 반복해서 입력했을 때 GPT-4가 얼마나 일관되고 동일한 주석 결과를 내놓는지(재현성)를 정량적으로 측정했습니다.
- GPT-4는 동일한 마커 유전자 목록에 대해 85%의 경우에서 완벽히 동일한 세포 타입 주석을 출력했습니다.
- 핵심 결론: 확률적 특성을 가진 언어 모델임에도 불구하고, GPT-4는 세포 타입 주석 작업에서 **매우 높은 재현성(High reproducibility)**을 보여주어 연구용 분석 도구로서 안정적으로 활용할 수 있음을 입증했습니다.

